微信公众号文章怎么入库:填上第三篇挖的坑
Web Clipper 抓不动公众号。这一篇给你一条真正跑得通的路——外加一个别全搬的忠告。
第三篇讲剪藏的时候,我在结尾留了句老实话:微信公众号是 Web Clipper 最吃力的场合。 正文一般能抓到,图片却经常裂,有些文章干脆整篇抓不动。
评论区和群里问得最多的也是这个——毕竟对中文读者来说,好文章的一半都锁在公众号里。
这一篇专门填这个坑。
一、先搞懂它为什么难:防盗链
不搞懂原因,你会一直以为是自己操作错了。其实不是你的问题:
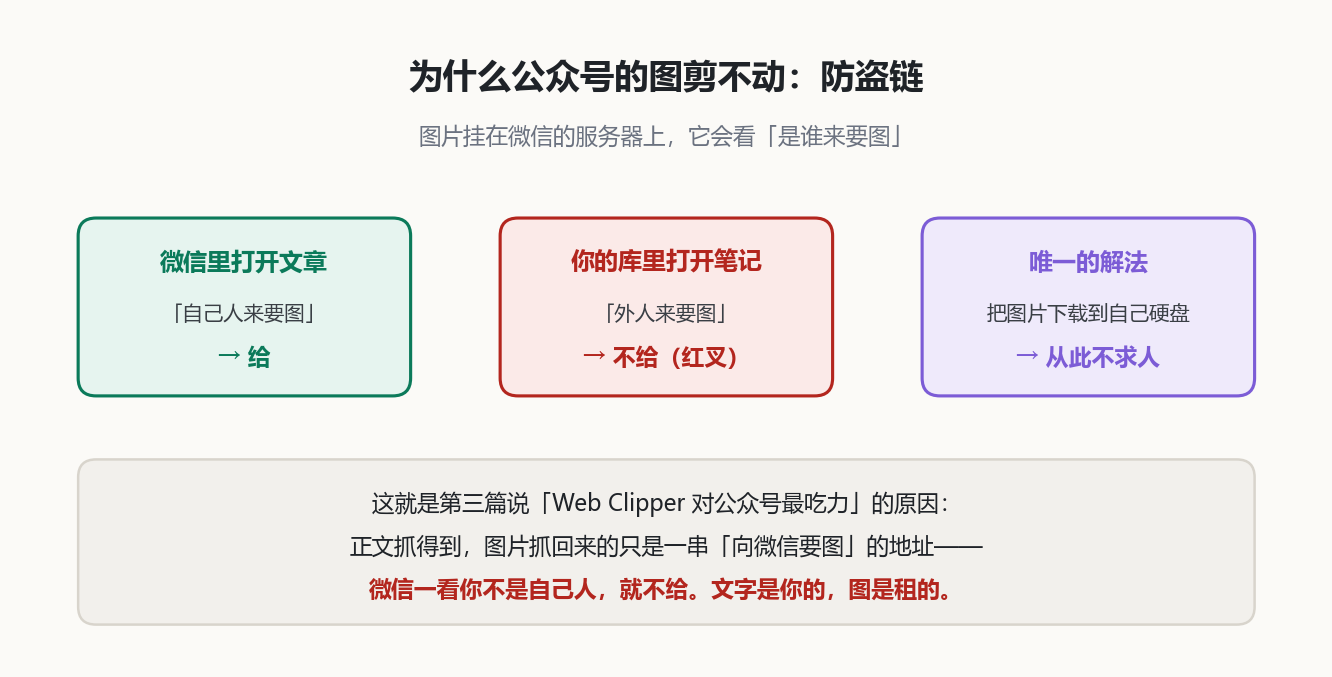
公众号文章里的图片,不在文章里,而是挂在微信自己的服务器上。每次有人要看图,微信的服务器会先看一眼:是谁来要?
- 在微信里打开文章——"自己人",给图;
- 在你的库里打开剪回来的笔记——"外人",不给,于是红叉。
这个机制叫防盗链,本意是防止别的网站白嫖微信的带宽。剪藏抓回来的只是一串"向微信要图"的地址,文字是你的了,图还是租的——这正是第二、三篇反复讲的那个坑的最极端版本。
唯一的解法也就显而易见了:把图片真正下载到你自己的硬盘上。
二、三条路,只有一条图文双全
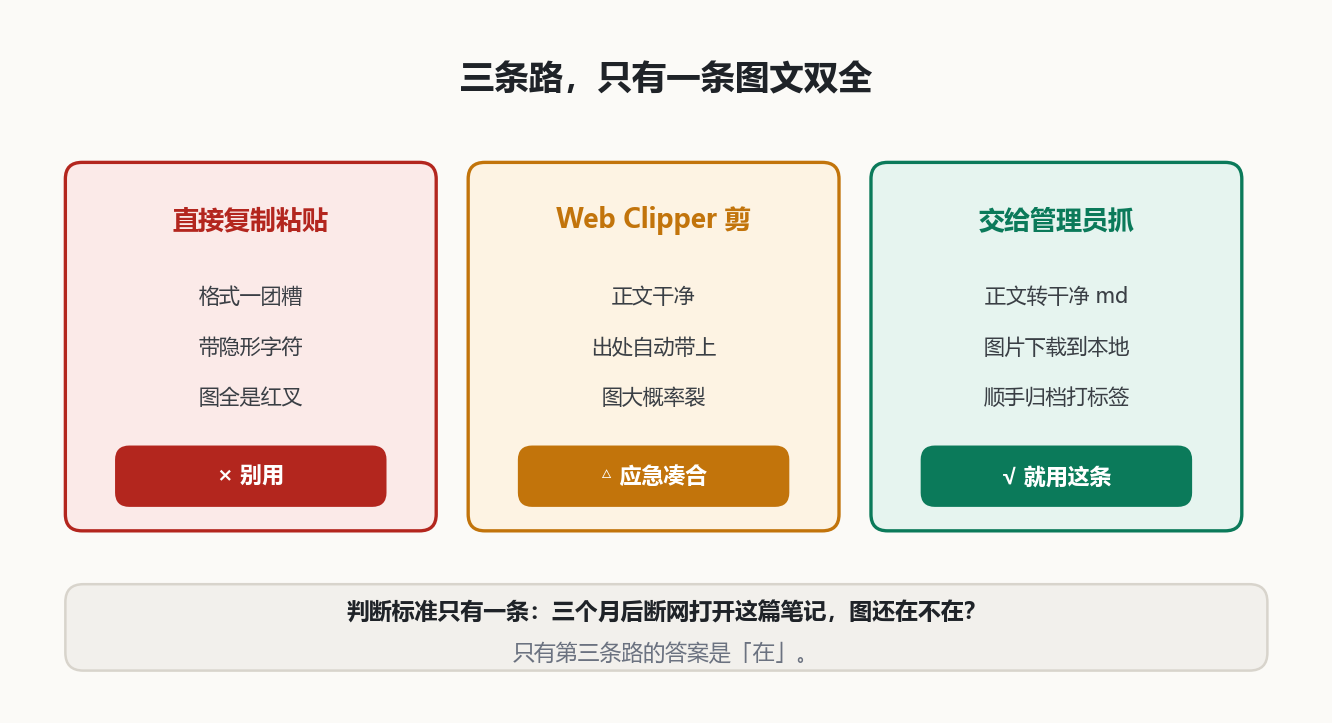
路线一:直接复制粘贴。 格式一团糟、带一堆隐形字符、图全是红叉。别用。
路线二:Web Clipper。 正文干净、出处自动带上——但图片大概率裂。应急凑合可以,存"只要文字"的文章可以。
路线三:交给管理员(Claude Code 或其他 AI Code,第四篇请的那位)。 正文转成干净的 md、图片下载到本地、顺手归档打标签。
判断标准就一条:三个月后断网打开这篇笔记,图还在不在? 只有路线三的答案是"在"。
三、我的日常流:四步,半分钟
具体操作,熟练之后半分钟:
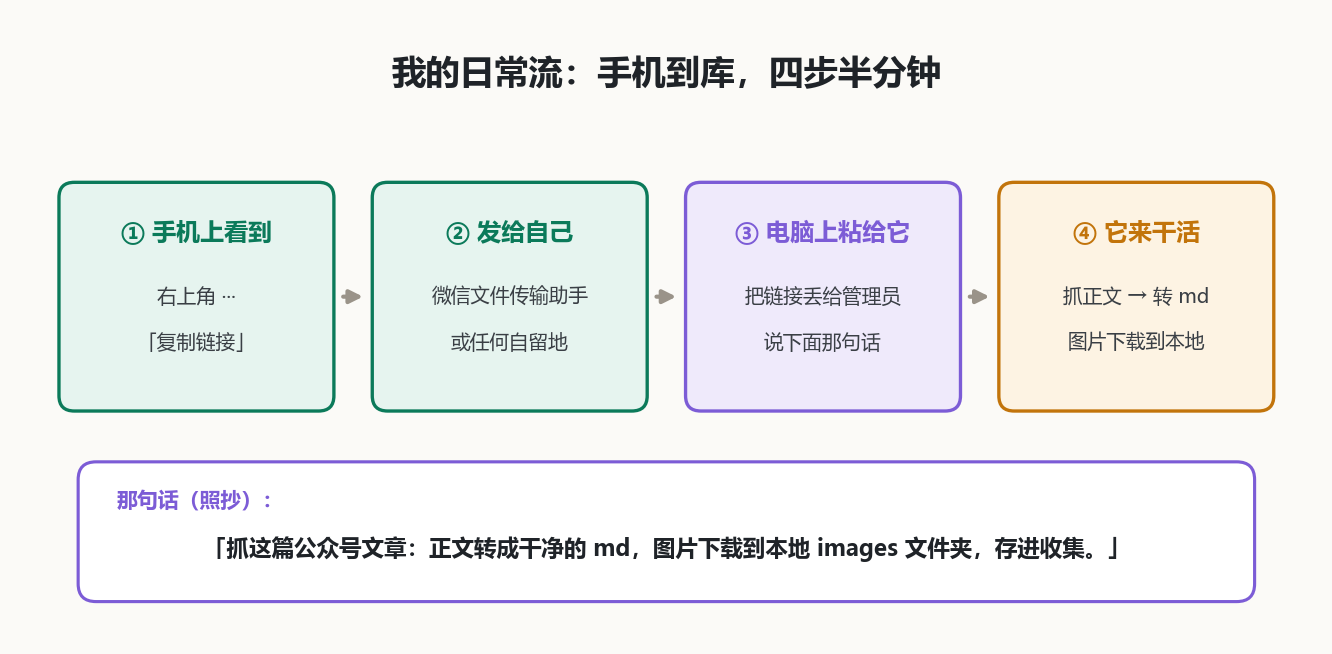
- 手机上看到好文章——右上角 ···,「复制链接」;
- 发给自己——微信文件传输助手,或任何你的自留地;
- 回到电脑,把链接粘给管理员,说这句话(照抄):
「抓这篇公众号文章:正文转成干净的 md,图片下载到本地 images 文件夹,存进收集。」
- 它来干活——抓正文、转格式、下图片、入库。
说过三遍之后,按第五篇的办法把这句话立成口令——我自己的版本就一个字:丢个链接,说"收"。
四、它也有抓不动的时候:两个备胎
老实说:公众号有反爬虫机制,偶尔连管理员也会被挡在门外(它会告诉你"抓取失败")。别硬磕,换个入口:
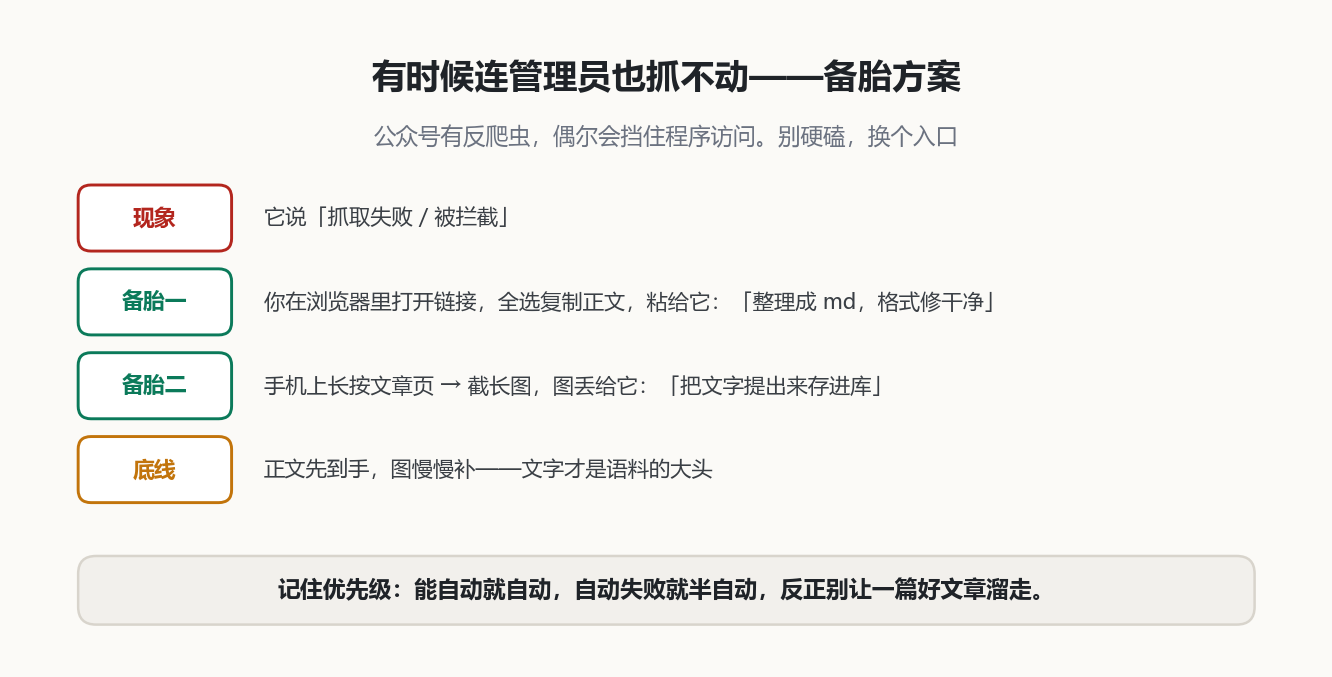
备胎一:你自己在浏览器里打开那个链接(大部分公众号文章浏览器能看),全选、复制正文,粘给它:"整理成 md,格式修干净。"图片这时候往往也能一起带过来。
备胎二:连浏览器都打不开的(少数设了"仅微信内打开"),手机上截长图,把图丢给它:"把文字提出来,存进库。"它认字的本事很好。
底线思维:正文先到手,图可以慢慢补。 对语料来说,文字才是大头。
五、忍住:别把六百篇收藏全搬进来
学会这招之后,几乎每个人都会冒出同一个念头:"我收藏夹里那六百篇,是不是可以全导进来了?"
忍住。
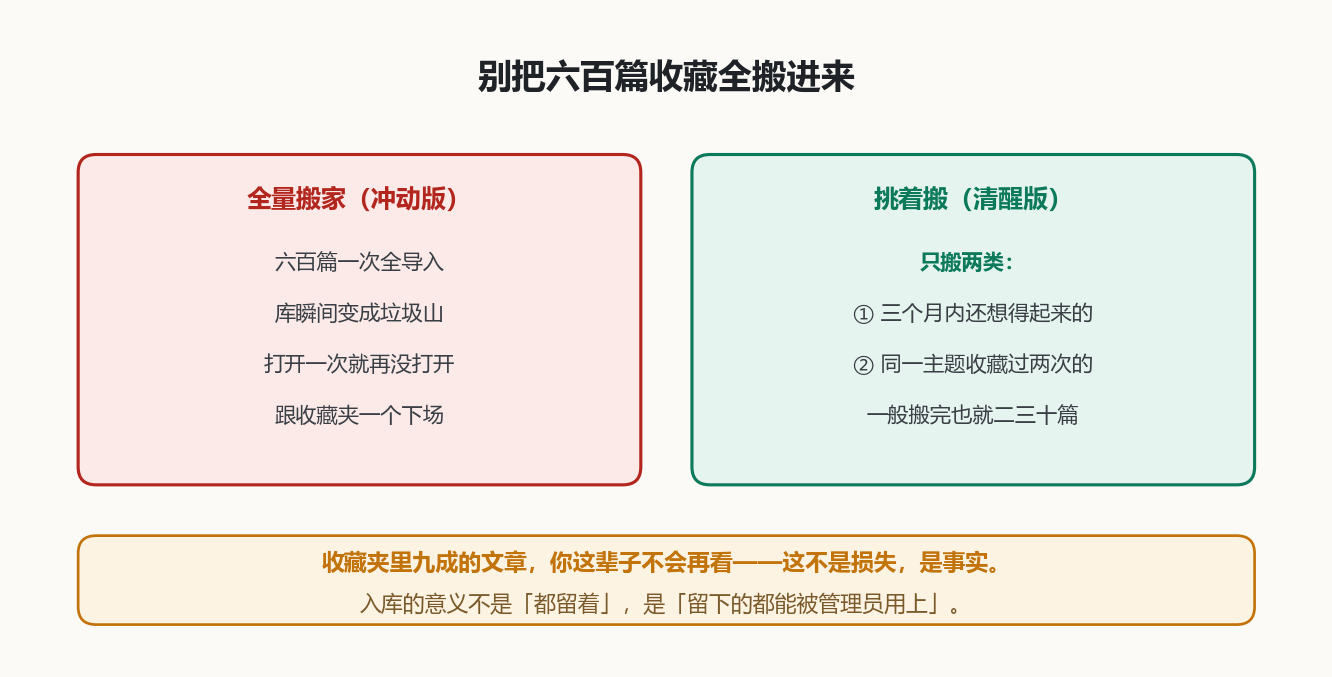
全量搬家的结局我见过(也差点自己干过):六百篇涌进库,库瞬间变成第二个收藏夹——打开一次,再也没打开。 你只是把坟从微信搬到了硬盘上。
挑着搬,标准就两条:
- 三个月内你还想得起来的——想不起来的,说明它对你没发生过作用;
- 同一主题收藏过两次以上的——重复收藏是你真实兴趣的投票。
按这两条筛,六百篇一般剩二三十篇。就搬这些。
剩下那些不是损失。收藏夹里九成的文章你这辈子不会再看,这不是你的失败,是收藏这个动作的本性——第三篇开头就说过了。
六、入库之后:它不是存着,是活着
最后回答一个根本问题:费这个劲,到底图什么?公众号文章躺在收藏夹里,和躺在库里,差别在哪?
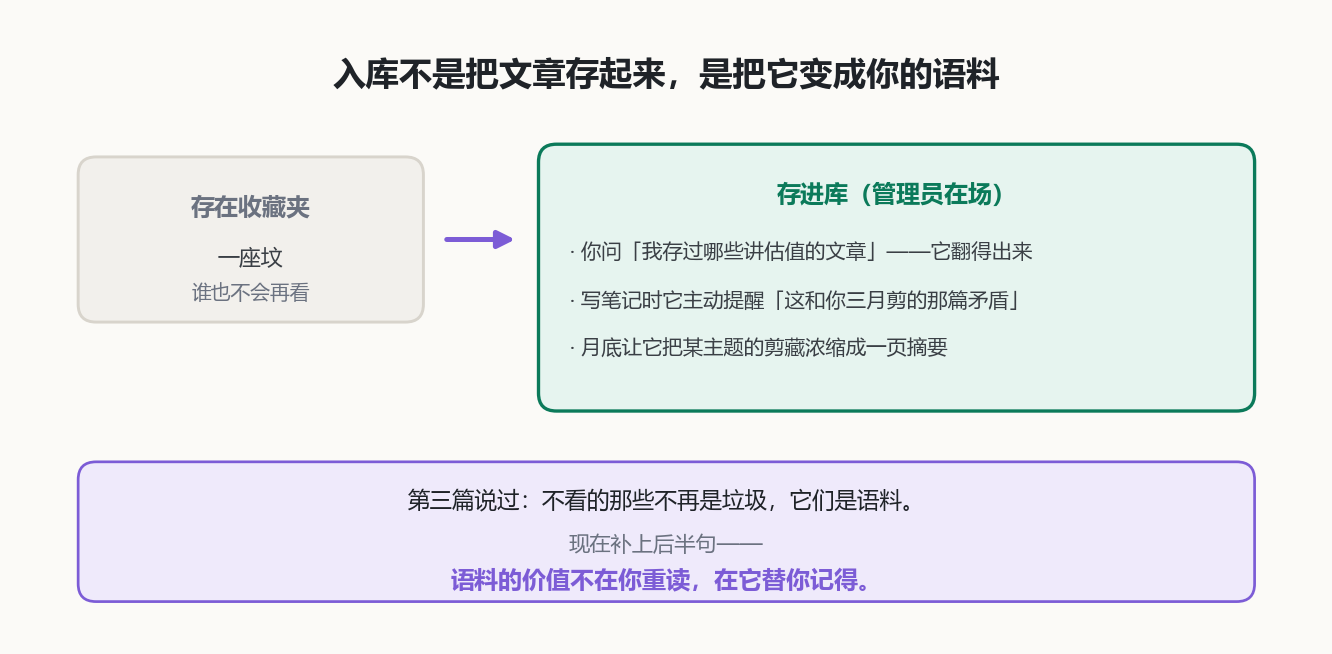
差别在于:库里有个管理员在场。
- 你问"我存过哪些讲估值的文章"——它翻得出来,还附每篇的要点;
- 你写笔记的时候,它主动提一句"这个观点和你三月剪的那篇正好相反";
- 月底你说一句"把这个月剪的关于 AI 的文章浓缩成一页"——它给你一页。
第三篇说过一句话:不看的那些不再是垃圾,它们是语料。 现在可以补上后半句了:
语料的价值不在你重读,在它替你记得。
七、新手最容易问的三件事
Q:视频号 / 小程序里的内容能抓吗? 基本不能,那是更封闭的墙。值得留的,用第六篇的办法:看完对着手机说三分钟感想,归档。你的理解本来就比原文值钱。
Q:付费文章 / 星球内容呢? 你花钱看的内容,存一份自用没问题;但抓取往往过不了登录墙,用备胎一(自己打开、复制、粘给它)最稳。别外传,尊重人家的饭碗。
Q:搬进来的文章要自己读一遍吗? 想读就读,不读也行。但我建议养成一个小习惯:入库的时候顺嘴说一句这篇为什么值得留("这篇讲的回购逻辑跟我想的不一样,留着对照")。这一句话,比整篇文章对未来的你更有用。
收尾
到这一篇,"进"这一侧就全通了:自己的想法用嘴(第六篇),网页文章用剪藏(第三篇),公众号这个最难啃的,现在也有了路。
你的库从此只有一个进料标准:看到好东西,别让它溜走。 至于格式、图片、归类——那是管理员的事。
下一篇解决"出"的第一步:东西攒多了怎么找——属性和 Bases,让一堆笔记变成一张能筛能排的表。 第二篇里那个让你"先跳过"的 frontmatter,要回收了。